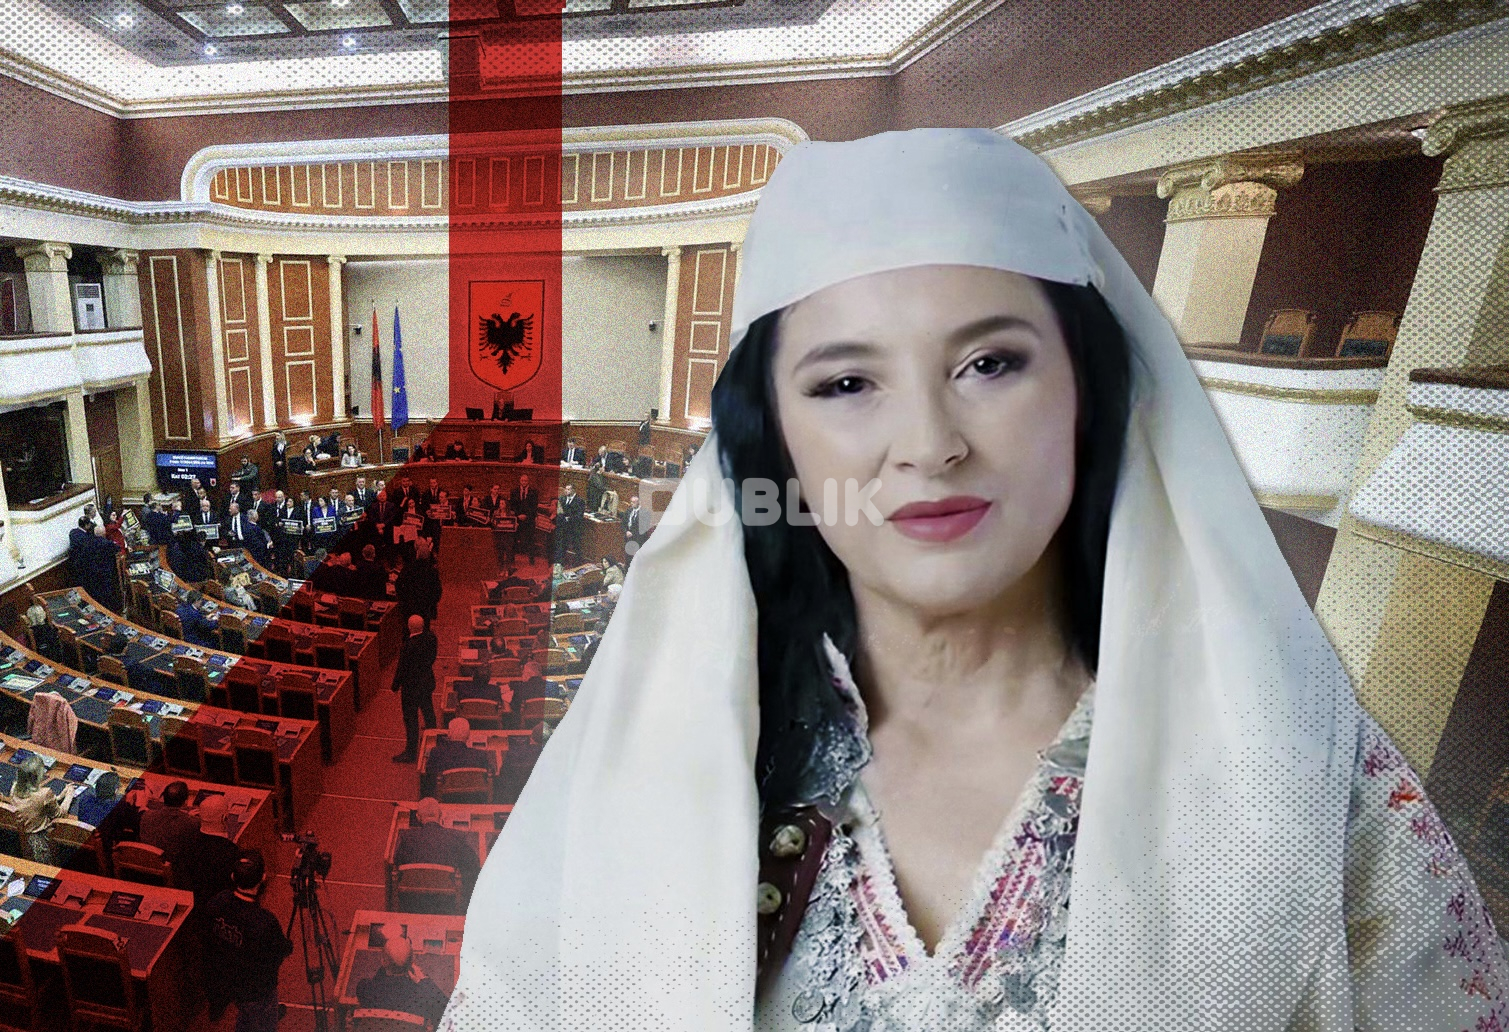
“Diella” pa tru?
Investigimi që trondit propagandën e AI-së: 32 GB të dhëna të Kuvendit të Shqipërisë të aksesueshme publikisht

Studiuesi amerikan i sigurisë kibernetike Patrick Quirk pretendon se shkarkoi 32 GB dokumente nga infrastruktura publike e Kuvendit, përfshirë 7 vite paga deputetësh. Gjetja më e fortë e tij: versioni publik i “ministres AI” Diella rezultonte vetëm një ndërfaqe Vue.js, pa një backend të identifikueshëm të inteligjencës artificiale.
Një investigim teknik i publikuar më 13 maj 2026 nga studiuesi i sigurisë kibernetike Patrick Quirk ngre pikëpyetje serioze mbi sigurinë e infrastrukturës digjitale të institucioneve shqiptare dhe, në veçanti, mbi atë që realisht qëndron pas projektit të shumëpromovuar qeveritar “Diella”.
Quirk thotë se përmes metodave OSINT dhe pa anashkaluar asnjë mekanizëm sigurie arriti të identifikojë API publike të Kuvendit të Shqipërisë, të shkarkojë rreth 32 gigabajt të dhëna, të analizojë mbi 52 mijë skedarë dhe të përpunojë të dhënat e pagave të deputetëve për më shumë se shtatë vite.
Por pretendimi më i fortë i investigimit lidhet pikërisht me “Diellën”.
Sipas analizës së Quirk, aplikacioni publik i prezantuar si pjesë e projektit të “ministres së Inteligjencës Artificiale” rezultonte një aplikacion Vue.js me framework-un Quasar, ndërsa studiuesi thotë se në kodin publik nuk identifikoi endpoint-e API, adresa backend-i apo referenca direkte te OpenAI, Azure Cognitive Services apo shërbime të tjera AI.
Me fjalë të tjera, përfundimi i Quirk është brutal: ajo që shihej publikisht ishte një ndërfaqe, por ai nuk arriti të gjente “trurin” teknologjik pas saj. (ringmast4r.substack.com)
Nga “ministrja që do zhdukte korrupsionin” te arrestimi i drejtuesve të AKSHI-t
Në shtator 2025, kryeministri Edi Rama prezantoi Diellën si një anëtare virtuale të kabinetit dhe deklaroi se përdorimi i inteligjencës artificiale do të synonte që tenderët publikë të bëheshin “100% pa korrupsion”.
Projekti mori vëmendje ndërkombëtare. Reuters raportoi në atë kohë se Diella do të ngarkohej gradualisht me funksione në fushën e prokurimeve publike, ndërsa TIME shkruante se sistemi ishte zhvilluar nga AKSHI në bashkëpunim me Microsoft dhe përdorte modele të OpenAI. (Reuters)
Vetëm tre muaj më vonë, në dhjetor 2025, drejtuesja e AKSHI-t, Mirlinda Karçanaj, dhe zëvendësdrejtoresha Hava Delibashi u vendosën nën masën e “arrestit në shtëpi” në kuadër të hetimeve të SPAK-ut për procedura prokurimi.
Karçanaj u akuzua ndër të tjera për shkelje të barazisë në tenderë dhe përfshirje në një grup të strukturuar kriminal, akuza që mbeten objekt i procesit gjyqësor. (Balkan Insight)
Paradoksi që evidenton investigimi është i fortë: institucioni që zhvilloi një sistem AI të reklamuar si instrument kundër korrupsionit u përfshi vetë në një nga hetimet më të mëdha për tenderët publikë.
 Gjurmët çojnë te Kuvendi
Fillimisht, Quirk thotë se synimi i tij ishte vetëm të analizonte pjesën publike të “Diellës”, për të parë nëse ekzistonin çelësa API të ekspozuar, URL backend-i apo dobësi të tjera.
Sipas tij, infrastruktura publike e AKSHI-t rezultoi relativisht e mbyllur.
Ai identifikoi përmes regjistrave të certifikatave rreth 110 nën-domene të lidhura me AKSHI-n: Jira, Rancher, Wiki të brendshme, VS Code Server, Collabora Online dhe shërbime të tjera, por shumica nuk ishin të aksesueshme nga interneti publik.
Quirk thotë se kontrolloi edhe 17 domene shtetërore shqiptare dhe gjeti kryesisht sisteme të mbrojtura me WAF, përgjigje “403 Forbidden”, API të kufizuara ose serverë që nuk përgjigjeshin.
Më pas kontrolloi Kuvendin e Shqipërisë.
Dhe aty, sipas tij, situata ndryshoi.
API pa çelës, pa token dhe pa autentikim
Faqja parlament.al funksionon si një aplikacion web React.
Duke analizuar paketën JavaScript të faqes, Quirk thotë se identifikoi një adresë bazë API të integruar drejtpërdrejt në kod, e lidhur me një backend OData të hostuar në Microsoft Azure.
Në kod shfaqeshin shtatë kategori të dhënash:
anetaret, strukturat, aktet, lajmet, mbledhjet, dokumentet dhe abonimet.
Sipas investigimit, gjashtë prej shtatë kategorive përgjigjeshin ndaj kërkesave standarde HTTP GET pa kërkuar:
● API key;
● bearer token;
● cookie sesioni;
● autentikim;
● kufizim të dukshëm të numrit të kërkesave.
Vetëm seksioni i abonimeve kthente përgjigjen “401 Unauthorized”.
Pikërisht ky detaj, sipas autorit, tregonte se infrastruktura e kishte mundësinë teknike të kërkonte autentikim, por kjo nuk ishte zbatuar te endpoint-et e tjera. (ringmast4r.substack.com)
236 deputetë dhe dhjetëra mijëra dokumente
Endpoint-i për anëtarët e Kuvendit, sipas Quirk, kthente 236 rekorde, ku përfshiheshin deputetë të legjislaturave të ndryshme.
Të dhënat përmbanin emër, atësi, mbiemër, datëlindje, vendlindje, email zyrtar, parti politike, qark elektoral, fotografi dhe profile në rrjetet sociale.
Por pjesa më e madhe e informacionit ndodhej te seksioni “dokumentet”.
Në fazën e parë të analizës, Quirk pretendon se katalogu përmbante 54,545 adresa direkte dokumentesh të ruajtura në Azure Blob Storage.
Dy muaj më vonë, numri kishte arritur në 57,287 rekorde.
Lista përfshinte, sipas tij:
● 32,627 dokumente PDF;
● afro 20 mijë fotografi;
● 885 dokumente Word;
● 509 tabela Excel.
Mes dokumenteve Excel, studiuesi thotë se gjeti lista mujore pagash të deputetëve, pagesa dhe përfitime, regjistra lobistësh dhe organizatash të shoqërisë civile, kërkesa dhe përgjigje për të drejtën e informimit, si dhe tabela buxhetore.
52,942 dokumente dhe 32 GB të dhëna
Më 15 prill 2026, Quirk thotë se iu rikthye sistemit.
Sipas tij, asnjë nga endpoint-et e konstatuara në shkurt nuk ishte mbyllur.
API vijonte të përditësohej me lajme, mbledhje dhe dokumente të reja.
Këtë herë ai vendosi të shkarkonte të gjithë materialin e aksesueshëm.
Rezultati që raporton është:
52,942 skedarë, 32 GB të dhëna dhe një normë rikuperimi prej 94.7%.
Materiali përfshinte rreth 18 GB PDF, 9 GB fotografi, transkripte parlamentare, projektligje, raporte komisionesh, tabela shpenzimesh buxhetore dhe marrëveshje ndërkombëtare.
Sipas autorit, dokumentet mbulonin periudhën nga viti 2013 deri në prill 2026.
11,030 rekorde pagash të deputetëve
Një nga pjesët më interesante të materialit ishte arkiva e pagave.
Quirk thotë se identifikoi 116 skedarë pagash, nga gushti 2018 deri në janar 2026.
Pas unifikimit të formateve të ndryshme të tabelave, ai përftoi:
11,030 rekorde pagash për 398 deputetë dhe ish-deputetë.
Sipas të dhënave të analizuara prej tij, struktura e pagave ndahej në disa nivele, nga drejtuesit e Kuvendit dhe grupet parlamentare deri te deputetët e zakonshëm.
Quirk evidenton gjithashtu kolonat e penaliteteve dhe zbritjeve nga paga për mungesa në seanca ose komisione.
Në një shembull të publikuar në investigim, Gazment Bardhi rezultonte për janarin 2026 me pagë bruto 356,788 lekë dhe pagesë neto 210,104 lekë.
Autori thekson se vetëm nga këto të dhëna nuk mund të përcaktohet nëse diferenca lidhej ekskluzivisht me mungesat apo me zbritje të tjera.
Një tjetër sistem: arkiva e transkripteve
Gjatë analizimit të JavaScript-it të Kuvendit, Quirk thotë se identifikoi edhe domenin bisedimet.parlament.al.
Sipas tij, aty funksiononte një sistem i veçantë i quajtur “Document Archive API”.
Health endpoint-i i serverit ekspozonte të dhëna teknike që, sipas studiuesit, përfshinin path-in e aplikacionit, përdorimin e memories dhe kohën që serveri kishte qenë aktiv.
Në sistem gjendeshin vetëm 20 transkripte parlamentare të përpunuara me OCR, që mbulonin periudhën 2022–2024 dhe përmbanin 261 folës të identifikuar.
Skema e databazës përmbante fusha për kërkim me vektorë dhe “embeddings”, teknologji që përdoren për kërkim semantik dhe sisteme AI.
Por Quirk thotë se statusi i embeddings për të gjitha dokumentet rezultonte PENDING.
Pra, sipas interpretimit të tij, funksionaliteti AI ishte parashikuar, por nuk rezultonte i përfunduar në momentin e testimit.
“Diella nuk kishte backend të dukshëm”
Pas Kuvendit, studiuesi u rikthye te Diella.
Ai analizoi sërish paketën JavaScript prej rreth 229 KB të aplikacionit Vue.js.
Quirk pretendon se kërkimi i tij dha:
zero endpoint-e API, zero URL backend-i dhe zero referenca direkte ndaj OpenAI, Azure Cognitive Services apo shërbimeve të tjera AI/ML.
Ai testoi gjithashtu disa hostname që, sipas strukturës së emërtimit, mund të ishin të lidhura me një backend të Diellës.
Një prej tyre, aibot-api.azurewebsites.net, sipas tij shfaqte vetëm faqen standarde të Azure App Service që sinjalizon se aplikacioni është ngritur, por përmbajtja nuk është publikuar.
Quirk identifikoi gjithashtu konfigurimin e autentikimit të Azure Static Web Apps, por thotë se nuk gjeti një aplikacion funksional publik pas tij.
Përfundimi i tij:
> Versioni publik që ai analizoi i “Diellës” ishte një frontend Vue.js dhe nga ai frontend nuk mund të identifikohej backend-i AI.
Kjo është një nuancë thelbësore: mungesa e një backend-i të identifikueshëm nga infrastruktura publike nuk provon domosdoshmërisht se një backend privat nuk ekziston.
Madje, raportime të tjera ndërkombëtare kanë cituar drejtues të AKSHI-t duke deklaruar se Diella përdor një model GPT të OpenAI të përshtatur në bashkëpunim me Microsoft. TIME raportonte në tetor 2025 se sistemi ende nuk ishte futur plotësisht në përdorim dhe se vendimmarrja e tij do të mbikëqyrej nga ekspertë njerëzorë. (TIME)
Për këtë arsye, pretendimi i Quirk se “Diella nuk ka backend” duhet lexuar si përfundim i auditimit të sipërfaqes publike që ai ishte në gjendje të testonte, jo si provë përfundimtare për të gjithë arkitekturën e brendshme të sistemit.
Shqipëria dhe historia e rrjedhjeve masive të të dhënave
Investigimi merr rëndësi të veçantë për shkak të historikut shqiptar të incidenteve me të dhënat.
Në prill 2021 u publikua databaza e njohur si skandali i “patronazhistëve”, me të dhëna të rreth 910 mijë qytetarëve, përfshirë informacione personale dhe të dhëna të lidhura me profilizimin elektoral. (Balkan Insight)
Në dhjetor të po atij viti, një tjetër databazë me pagat dhe të dhënat personale të 637,138 qytetarëve shqiptarë nisi të qarkullonte në WhatsApp. Qeveria e konfirmoi rrjedhjen dhe Rama deklaroi se indiciet e para sugjeronin më shumë një infiltrimin të brendshëm sesa një sulm të jashtëm kibernetik. (The Record from Recorded Future)
Në vitin 2022, Shqipëria u godit nga sulme të koordinuara kibernetike që autoritetet amerikane ia atribuuan aktorëve shtetërorë iranianë.
CISA dhe FBI dokumentuan hyrjen e aktorëve iranianë në rrjetet qeveritare shqiptare, lëvizjen laterale në sistem dhe vjedhjen e të dhënave përpara operacioneve shkatërruese. (CISA)
Paradoksi i “qeverisjes me AI”
Patrick Quirk e përmbledh investigimin e tij me një kritikë shumë më të gjerë sesa problemi i një API-je të hapur.
Sipas tij, nuk mund të ndërtohet qeverisje me inteligjencë artificiale mbi një infrastrukturë që nuk ka zgjidhur më parë problemet bazë të autentikimit, sigurisë së të dhënave dhe kontrollit të aksesit.
Në rastin shqiptar, kontrasti është evident.
Qeveria prezantoi një “ministre AI” si armë kundër korrupsionit në tendera.
Pak muaj më vonë, drejtuesit e institucionit përgjegjës për infrastrukturën digjitale u vunë nën akuzë pikërisht për tendera.
Ndërkohë, një studiues i jashtëm pretendon se mundi të aksesonte me kërkesa të zakonshme HTTP dhjetëra mijëra dokumente të Kuvendit dhe se nga infrastruktura publike e “Diellës” nuk identifikoi sistemin AI që do të pritej pas fasadës.
Dhe pikërisht këtu qëndron pyetja që investigimi lë të hapur:
A kemi të bëjmë me një sistem real dhe të auditueshëm të inteligjencës artificiale që do të kontrollojë korrupsionin në prokurime, apo me një projekt politik të promovuar shumë më shpejt sesa është ndërtuar infrastruktura teknike që duhet ta mbështesë?
Deri në publikimin e dokumentacionit teknik, arkitekturës së sistemit, auditimeve të pavarura dhe mekanizmave konkretë të kontrollit, përgjigjja nuk mund të jepet vetëm nga konferencat për shtyp.
Metodologjia e autorit
Patrick Quirk deklaron se të gjitha informacionet janë marrë vetëm nga endpoint-e dhe dokumente të aksesueshme publikisht dhe pa autentikim.
Sipas tij:
● nuk është anashkaluar autentikimi;
● nuk janë përdorur kredenciale;
● nuk janë thyer mekanizma sigurie;
● nuk është shfrytëzuar ndonjë dobësi për të fituar akses të paautorizuar.
Faza e parë e hulumtimit është zhvilluar më 25 shkurt 2026, ndërsa faza e dytë më 15–16 prill 2026.
Analiza është kryer përmes teknikave standarde OSINT, analizës së JavaScript-it, kërkesave HTTP, skripteve Python dhe përpunimit të skedarëve XLSX.
Investigimi origjinal i Patrick Quirk u publikua më 13 maj 2026 me titullin “The AI Minister’s Blind Spot: How Albania’s Anti-Corruption Bot Can’t See Its Own Parliament’s Open API”. (ringmast4r.substack.com)
Korrigjim i Heshtur: Parlamenti i Shqipërisë Mbylloi 32 Gigabajt të Dhëna të Hapura Qeveritare. Askush Nuk E Tha.
Gjashtë javë pas publikimit të provave se Parlamenti i Shqipërisë kishte lënë 32 gigabajt të dhëna qeveritare të pambrojtura në një API publike, çdo pikë fundore u errësua. Qeveria shqiptare nuk tha a
Sfondi
Në maj 2026, publikova një hetim mbi ministren e kabinetit AI të Shqipërisë, Diella, dhe çfarë gjeta kur shikova infrastrukturën dixhitale që ajo ishte caktuar të qeveriste.
Versioni i shkurtër: Parlamenti shqiptar kishte drejtuar një API OData pa vërtetim për të paktën katër vjet. Gjashtë nga shtatë pikat fundore nuk kërkonin vërtetim, asnjë çelës API, asnjë token sesioni, asnjë cookie. Pika fundore “dokumentet” kthente një katalog të çdo dokumenti të ngarkuar në Azure Blob Storage të Parlamentit, duke përfshirë 54.545 lidhje direkte shkarkimi. I tërhova të gjitha. Të gjitha 52.942 skedarët e gjallë. 32 gigabajt.
Të dhënat përfshinin shtatë vjet të dhëna pagash për 398 zyrtarë, transkripte parlamentare, draft-ligje, regjistrat e lobistëve dhe organizatave të shoqërisë civile. Gjithçka publike, e aksesueshme nga çdo shfletues, e prodhuar nga një kërkesë standarde HTTP GET.
Vetë sistemi AI Diella, ai i emëruar për të rrënjosur korrupsionin, nuk kishte asnjë bazë funksionale. Drejtori i Përgjithshëm i AKSHI-t që kishte mbikëqyrur krijimin e saj ishte i akuzuar për manipulim të tenderëve qeveritarë që Diella duhej të monitoronte (Tirana Times).
Ky artikull u botua në Substack në maj 2026.
Çfarë Gjeta në Qershor
Më 19 qershor 2026, ri-testova çdo pikë fundore.
URL-ja bazë e API-t që ishte e koduar fort në paketën JavaScript të Parlamentit ende zgjidhet. Domeni ende i përgjigjet. Por përgjigjet kanë ndryshuar plotësisht.
Çdo pikë fundore që më parë kthente të dhëna JSON tani kthen HTML-në e faqes kryesore të Parlamentit. Jo 401. Jo 403. Jo “shërbim i padisponueshëm.” Serveri thjesht pretendon se pika fundore është një faqe dhe dorëzon ndërfaqen.
Para (maj 2026):
GET /odata/anetaret
HTTP/1.1 200 OK
Content-Type: application/json
{"@odata.count":236,"value":[{"id":1,"emer":"Kasem"...}
Pas (qershor 2026):
GET /odata/anetaret
HTTP/1.1 200 OK
Content-Type: text/html
<!DOCTYPE html>...
Të gjashtë pikat fundore të hapura më parë janë mbyllur. Pika fundore “dokumentet” që kthente katallogun JSON 30-megabajt: e mbyllur. Pika fundore “anetaret” që kthente 236 të dhëna deputetësh me PII të plota: e mbyllur. Pikat fundore “aktet”, “lajmet” dhe “mbledhjet”: e mbyllura. API-ja e nëndomenit “bisedimet” për transkriptet, e cila gjendej duke xhiruar si root me 92% memorie në një server prodhimi me shtegun e ekspozuar: edhe ajo duket se është adresuar.
E vetmja pikë fundore që kishte kërkuar vërtetim edhe më parë, “abonimet”, ende e bën këtë. Gjithçka që kishte qenë e hapur tani është e mbyllur.
Heshtja
Asnjë CVE nuk u paraqit. Autoriteti Kombëtar i Sigurisë Kibernetike (AKCESK) nuk ka publikuar asgjë. Zyra e shtypit e Parlamentit nuk ka bërë asnjë deklaratë. Nuk pati asnjë postim “e rregulluam”, asnjë njoftim për palët e prekura, asnjë zbulim publik se çfarë të dhënash mund të jenë aksesuar gjatë viteve që API ishte e hapur.
Korrigjimi ndodhi diku midis majit dhe qershorit 2026, u ekzekutua qetë, dhe pastaj asgjë.
Kjo vlen të theksohet sepse të dhënat e ekspozuara përfshinin PII të plota për 236 deputetë në detyrë. Sipas Rregullores së Përgjithshme të Mbrojtjes së të Dhënave (GDPR) të Bashkimit Europian, organizatat janë përgjithësisht të detyruara të njoftojnë autoritetin mbikëqyrës relevant brenda 72 orëve pasi të kenë dijeni për një shkelje të të dhënave personale, dhe të njoftojnë individët e prekur kur shkelja paraqet rrezik të lartë. Shqipëria është vend kandidat për anëtarësim në BE dhe ka miratuar legjislacion të mbrojtjes së të dhënave të modeluar sipas GDPR.
Nuk jam në pozicion të përcaktoj nëse interpretimi ligjor i Parlamentit është se ka ndodhur një shkelje e të dhënave. Por mund të konfirmoj se të dhënat ishin publike dhe të aksesueshme për të paktën katër vjet, se dokumentimi i ekspozimit u publikua dhe u shpërnda gjerësisht, dhe se asnjë njoftim nuk është bërë publik.
Çfarë Bëri Publikimi
Artikulli origjinal arriti 22.226 përshtypje në LinkedIn me 311 reagime. U mblodh nga mediat kombëtare shqiptare. Deputetët e opozitës i përdorën rezultatet në procedurat parlamentare.
Kur rezultatet e një hetimi Substack përfundojnë të cituara në legjislaturën e vendit që hetohet, kjo është një reagim zinxhir kuptimplotë. Anëtarët e Parlamentit që lexonin mbulimin mediatik ishin, në disa raste, të njëjtët individë, të dhënat e pagave dhe PII e të cilëve kishin qenë në atë API pa vërtetim. Njerëzit më të prekur ishin në sallë ku ndodhi diskutimi.
Edhe kundërvënia ishte reale. Alban Xhaferllari, një Inxhinier Kryesor i Microsoft që punonte në projekte qeveritare shqiptare, sfidoi publikisht disa nga pretendimet teknike. Dr. Julia Hoxha ngriti kundërshtime metodologjike. Të dyja kundërshtimet ishin teknike në natyrë dhe të dyja janë pjesë e rekordit publik. Artikulli i mbijetoi atij shqyrtimi. Dhe gjashtë javë më vonë, pikat fundore u mbyllën.
Tabloja e Madhe
Korrigjimet e heshtura janë më të mira se asgjë. Një API e mbyllur nuk mund të mblidhet nga askush që e gjen. Të dhënat që Parlamenti shërben tani janë të kufizuara, gjë që ishte ajo çfarë duhej të kishte qenë që nga fillimi.
Por një korrigjim i heshtur nuk është mekanizëm llogaridhënieje. Ai nuk i përgjigjet pyetjeve të dukshme: kush i aksesoi të dhënat para mbylljes? A u përdor ndonjë nga 32 gigabajtat për qëllime të tjera nga gazetaria? A u morën veprime ndaj zyrtarëve përgjegjës për ekspozimin katërvjeçar?
Rekordi i Shqipërisë për mbrojtjen e të dhënave i bën ato pyetje më të vështira për t’i hedhur poshtë. Në prill 2021, të dhënat e 910.000 qytetarëve, rreth një e treta e popullsisë, rrjedhën në një bazë të dhënash të qarkulluar online (Balkan Insight). Në dhjetor 2021, të dhënat e pagave të 637.138 qytetarëve rrjedhën nëpërmjet WhatsApp. Në vitin 2022, grupi Iranian i sponsorizuar nga shteti HomeLand Justice shpoi vetë AKSHI-n, duke pretenduar 100 terabajt të eksfiltruara dhe 2 petabajt të fshira (Këshillimi i CISA AA22-264A; MITRE ATT&CK).
Secili nga ato incidente mori njëfarë forme njoftimi publik. Ky nuk mori. Korrigjimi u shfaq qetë, dhe heshtja është vetë përgjigja e tij.
Çfarë Ruajta
Kopja lokale e plotë e gjithçkaje të tërhequr në prill 2026 mbetet intakte: 52.942 skedarë, 32,09 gigabajt, në magazinën lokale. Katalogu i API-t, tabelat e pagave, të dhënat PII të deputetëve, baza e të dhënave të transkripteve bisedimet, URL-të e blob storage. Asnjë prej tyre nuk është publikuar, shpërndarë apo ndarë me asnjë palë të tretë. E gjitha u mblodh ligjërisht nga pikat fundore publike, pa vërtetim, duke përdorur kërkesa standarde HTTP GET.
Të dhënat ekzistojnë si rekor i përhershëm i asaj çfarë u ekspozua dhe kur. Nëse Parlamenti zgjedh të pretendojë se ekspozimi nuk ndodhi kurrë, ose se pikat fundore kishin qenë gjithmonë të sigurta, arkivi lokal i përgjigjet asaj pretendimi.
Metodologjia
E gjithë ri-testimi i pikave fundore u krye më 19 qershor 2026, duke përdorur kërkesa standarde HTTP GET. Asnjë vërtetim nuk u tentua. Asnjë kontroll aksesi nuk u anashkalua. Ndryshimi në sjelljen e pikave fundore, nga përgjigjet e të dhënave JSON në përgjigjet e ridrejtimit HTML, u konfirmua nëpër të gjitha gjashtë pikat fundore të hapura më parë dhe pikën fundore shëndetësore bisedimet.
Hetimi origjinal u krye më 25 shkurt 2026 (Faza 1) dhe 15-16 prill 2026 (Faza 2). Rezultatet e plota dhe metodologjia u publikuan në maj 2026.
Keni një histori? Denonco anonimisht, identiteti juaj mbrohet.
Denonco